Языковая модель сама по себе не знает содержание внутренних регламентов, договоров, инструкций и других документов компании. RAG позволяет перед формированием ответа найти нужные сведения во внешней базе знаний и передать их модели как дополнительный контекст. Например, сотрудник спрашивает: «Какой срок согласования заявки указан в действующем регламенте?» RAG-система находит нужный фрагмент документа, передает его языковой модели, формирует понятный ответ и может показать, из какого регламента и раздела взяты сведения.
При этом RAG не делает ответ автоматически правильным. Качество зависит от документов, поиска, актуальности данных, прав доступа и того, насколько корректно языковая модель использовала найденную информацию.
Что такое RAG
RAG — сокращение от Retrieval-Augmented Generation, или «генерация с дополнением поиском». Перед ответом система ищет подходящую информацию во внешних источниках и передает найденные сведения языковой модели как контекст.
То есть RAG состоит из двух связанных частей:
- система находит информацию, которая относится к вопросу;
- языковая модель использует ее как контекст для формирования ответа.
RAG — не отдельная нейросеть, не языковая модель и не база данных. Это архитектурный подход, который связывает механизм поиска с генеративной моделью. Также документы компании в базовом RAG-сценарии не «обучают» модель. Они остаются во внешнем хранилище или поисковом индексе. При каждом запросе система выбирает подходящие фрагменты и временно передает их модели вместе с вопросом пользователя. Это позволяет работать с корпоративными знаниями, не переобучая модель после каждого изменения регламента, инструкции или прайс-листа.
Зачем RAG нужен языковой модели
Большая языковая модель (LLM) формирует ответы на основе своих параметров и информации, которую получает в текущем контексте. В ее исходных знаниях может не быть внутренних документов конкретной компании, а информация о продуктах, ценах или процессах может измениться после обучения модели.
Можно каждый раз вручную прикладывать нужный документ к запросу. Это работает, когда файлов мало и пользователь заранее знает, где искать. RAG решает другую задачу: система сама выбирает из большой базы знаний именно те сведения, которые нужны для конкретного вопроса. Например, вместо передачи модели нескольких сотен инструкций можно найти три наиболее подходящих фрагмента и использовать только их.
На практике RAG часто становится поисковой частью ИИ-консультантов и корпоративных баз знаний: пользователь задает вопрос обычным языком, а система ищет корпоративную информацию и формирует на ее основе ответ.
Как работает RAG-система
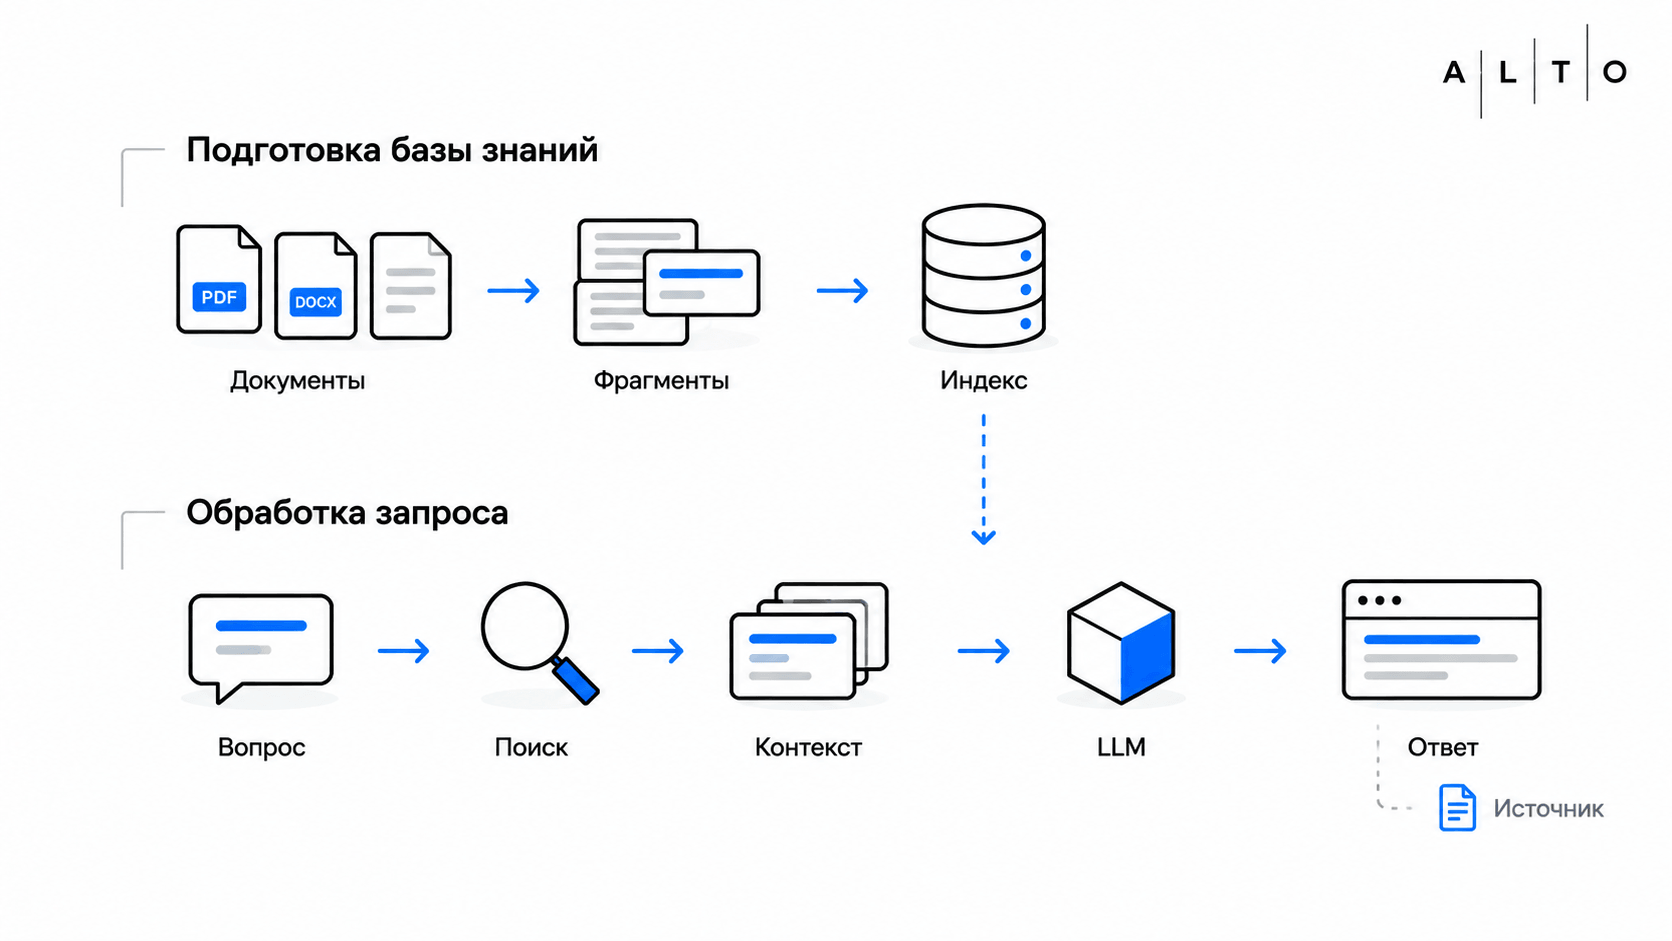
Работу RAG удобно разделить на два процесса. Первый происходит заранее: компания подготавливает документы и создает поисковый индекс. Второй запускается при каждом вопросе пользователя: система ищет нужную информацию и передает ее языковой модели.
Документы компании → подготовка → поисковый индекс → вопрос пользователя → поиск → релевантные фрагменты → языковая модель → ответ → источник
Документы подготавливают и разбивают на смысловые фрагменты
Источниками для RAG могут быть PDF- и Word-файлы, инструкции, договоры, регламенты, корпоративные базы знаний, страницы внутренних систем и другие материалы. Но просто сложить файлы в одну папку недостаточно. Перед индексацией документы обычно очищают от технического мусора, проверяют структуру, исключают ненужные дубли и определяют, какие версии должны участвовать в поиске.
Большой документ также неудобно искать целиком. Если пользователь спрашивает про один пункт договора, модели необязательно получать все сто страниц. Поэтому документы разбивают на небольшие логически завершенные смысловые фрагменты. В технической литературе такой процесс часто называют чанкингом. Размер фрагмента нужно выбирать под конкретные документы и задачи. Слишком маленькая часть может потерять контекст, а слишком большая — содержать много нерелевантной информации.
Важно также сохранить связь каждого фрагмента с исходным документом: его названием, разделом, страницей, датой, версией и другими метаданными. Позже эта связь понадобится и для поиска, и для показа источников.
Информацию индексируют
Подготовленные фрагменты помещают в поисковый индекс, чтобы система могла быстро сопоставлять их с вопросами пользователей. Индекс необязательно означает только векторную базу данных. Реализация зависит от типа информации и задачи. Для смыслового поиска текст можно преобразовать в числовое представление его значения — эмбеддинг. Такое представление позволяет сравнивать не только совпадение конкретных слов, но и близость смысла. Одновременно система может сохранять обычный текст и метаданные: название документа, категорию, дату, версию, подразделение, статус и права доступа.
По запросу находят релевантные фрагменты
Когда пользователь задает вопрос, RAG-система сначала ищет информацию, которая может помочь ответить. Например: «Какие документы нужны для возврата оборудования по гарантии?» В корпоративной базе знаний может не быть документа с точно такой формулировкой. Там может быть раздел «Порядок рассмотрения рекламаций». Смысловой поиск способен определить, что эти формулировки связаны, и вернуть подходящий фрагмент. Система может найти сразу несколько кандидатов. При необходимости результаты дополнительно фильтруют или повторно ранжируют, чтобы выше оказались наиболее полезные части документов.
Найденные данные передают языковой модели
После поиска модель получает не всю корпоративную базу знаний, а вопрос пользователя и выбранные фрагменты.
Условно запрос для модели может выглядеть так:
- Вопрос: какие документы требуются для гарантийного возврата?
- Найденный контекст: пункт 4.2 регламента рекламаций, список обязательных документов и условия возврата.
- Задача: сформировать ответ только на основании предоставленной информации и указать источник.
Языковая модель анализирует вопрос и найденный материал и формирует понятный человеку ответ. Корпоративные сведения при этом не обязательно становятся частью параметров модели. В базовом RAG-подходе они используются как контекст конкретного запроса.
Как RAG находит нужную информацию
Если поиск вернул не тот фрагмент, хорошая LLM уже не спасёт ответ. Даже сильная языковая модель не сможет правильно ответить по корпоративным документам, если ей передали нерелевантный или устаревший фрагмент. Поэтому качество RAG зависит не только от выбранной LLM, но и от того, как организован поиск.
Векторные представления и смысловой поиск
Компьютеру сложно напрямую сравнивать смысл двух текстов. Для этого текст можно преобразовать в набор чисел — векторное представление, или эмбеддинг. Упрощенно можно представить его как координаты смысла текста. Похожие по значению фразы получают близкие представления, даже если в них используются разные слова.
Например:
- «Когда поступит заказ?»
- «Какой срок поставки продукции?»
Лексически формулировки различаются, но по смыслу близки. Векторный поиск позволяет находить такие связи. Поэтому он удобен для корпоративных баз знаний, где сотрудник может сформулировать вопрос совсем не так, как автор регламента.
Зачем нужна векторная база
Векторная база данных хранит векторные представления фрагментов и позволяет быстро находить те из них, которые наиболее близки к запросу по смыслу. Это распространенный компонент RAG-систем, особенно когда документов много.
Но формула RAG = векторная база + LLM слишком упрощает архитектуру. RAG определяется не наличием конкретной базы, а принципом: сначала система извлекает внешние знания, затем использует их для генерации ответа. В качестве поиска могут использоваться и другие методы.
Поиск по словам и гибридный поиск
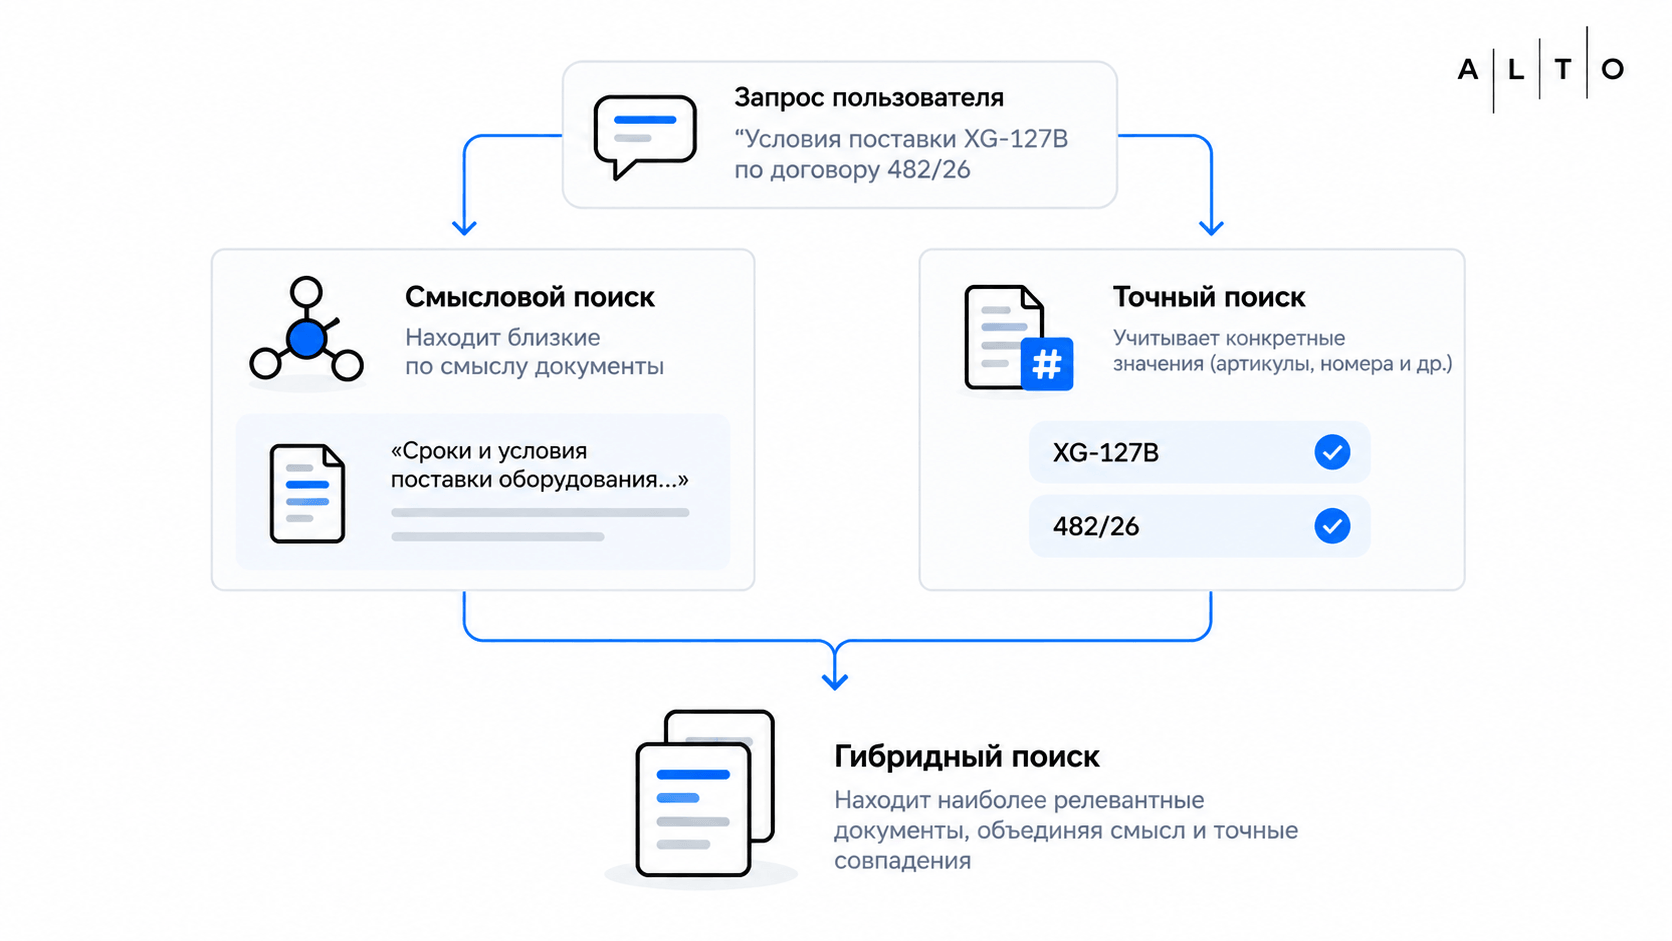
Смысловой поиск хорош не для всех данных. Представим каталог промышленного оборудования. Пользователь спрашивает: «Какие условия поставки для модели XG-127B по договору 482/26?» Обозначение XG-127B и номер 482/26 важны буквально. Если система будет искать только по смысловой близости, она может найти похожие модели или соседние договоры. Для артикулов, номеров договоров, кодов, названий моделей и других точных значений хорошо подходит поиск по словам и символам.
Поэтому в корпоративных RAG-системах часто используют гибридный подход:
- смысловой поиск находит близкую по смыслу информацию;
- поиск по словам учитывает точные совпадения;
- дополнительные фильтры ограничивают поиск по типу документа, дате, подразделению, версии или другим признакам.
Для русскоязычной базы также важно, насколько выбранные модели смыслового поиска работают с русским языком и с терминологией конкретной компании.
Как RAG показывает источники ответа
Одна из практических ценностей корпоративного RAG — возможность не только получить готовый ответ, но и проверить, откуда взяты сведения.
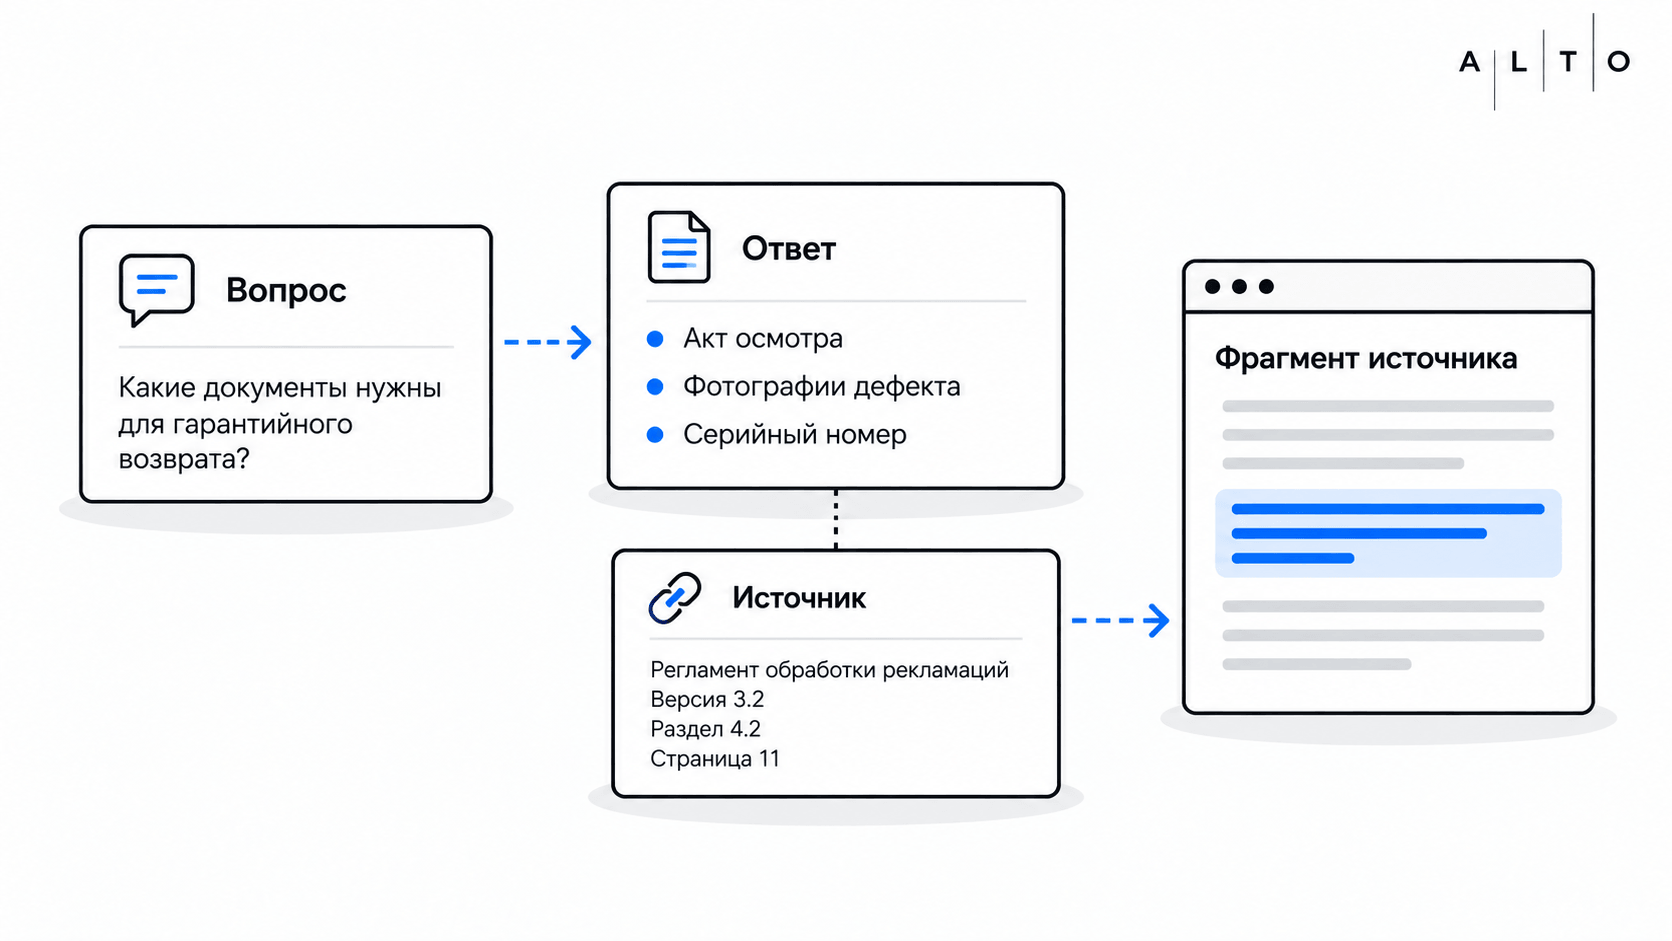
Например: Гарантийная заявка должна содержать акт осмотра, фотографии дефекта и серийный номер оборудования. Под ответом система может показать: Регламент обработки рекламаций, версия 3.2, раздел 4.2, страница 11. Пользователь открывает документ и проверяет исходный фрагмент.
Но источник не появляется автоматически только потому, что используется RAG. Чтобы его показать, при подготовке базы знаний нужно сохранить связь между каждым индексируемым фрагментом и исходным документом.
Какие сведения об источнике можно сохранять
В зависимости от задачи вместе с фрагментом можно хранить:
- название документа;
- раздел или заголовок;
- номер страницы;
- ссылку на исходный файл или страницу;
- дату публикации;
- дату обновления;
- номер версии;
- статус — например, «действующий» или «архивный»;
- автора или владельца документа.
Когда система использует фрагмент для ответа, эти метаданные можно вывести пользователю. Источник делает ответ проверяемым, но не гарантирует его правильность. Система могла найти устаревшую версию документа. Выбранный фрагмент мог быть неполным. Языковая модель могла неверно понять даже правильный источник. Поэтому наличие ссылки — важный механизм контроля, а не доказательство безошибочности системы.
Пример: как RAG отвечает по документам компании
Например, менеджеру поставщика оборудования приходит вопрос: «Какой срок поставки модели AB-500 и можно ли оплатить заказ в два этапа?»
Информация хранится в нескольких местах:
- актуальном прайс-листе;
- продуктовой документации;
- типовых коммерческих условиях;
- приложении к договору с конкретным клиентом.
Без RAG менеджеру нужно определить, в каких файлах искать, открыть их, найти нужные пункты, проверить версии и собрать ответ. RAG-система действует иначе. Сначала она определяет, какие корпоративные материалы доступны этому сотруднику и относятся к запросу. Затем находит фрагмент с моделью AB-500, действующие условия поставки и пункт договора о порядке оплаты. После этого языковая модель получает найденные сведения и может сформировать ответ. Рядом система показывает документы и разделы, из которых взяты утверждения. Сотрудник получает не просто список подходящих файлов, а собранный ответ и возможность проверить его по первоисточнику.
Это и есть принципиальная разница между поиском корпоративной информации и RAG: поиск помогает найти документ, а RAG может использовать найденное содержимое для формирования ответа.
От чего зависит качество и надежность RAG-системы
RAG часто воспринимают как задачу выбора языковой модели и векторной базы. В корпоративной системе этого недостаточно.
Качество ответа определяется всей цепочкой: документы → подготовка → индекс → поиск → найденный контекст → языковая модель → правила ответа
Качество и актуальность документов
Если в базе знаний лежат три версии одного регламента без указания, какая действует, RAG не может сам догадаться о внутренней политике компании.
Проблемы создают:
- устаревшие документы;
- черновики;
- дубли;
- противоречащие друг другу материалы;
- ошибки распознавания отсканированных PDF;
- таблицы, структура которых потерялась при извлечении текста;
- документы без даты и версии;
- технические страницы и служебный мусор.
Поэтому корпоративную базу знаний нельзя рассматривать как папку, куда один раз загрузили файлы. Нужно определять правила обновления, архивирования, удаления дублей и контроля актуальности.
Как учитывать версии документов
Представим, что в январе действовал регламент версии 2.1, а с июля — версия 3.0. Если обе версии одинаково участвуют в поиске, система может найти старое правило и сформировать по нему ответ. Поэтому вместе с документом полезно хранить дату, номер версии, статус актуальности и владельца информации. Поиск должен учитывать эти признаки и отдавать приоритет действующим материалам в соответствии с правилами компании. Старые версии при этом необязательно удалять. Они могут быть нужны для исторических запросов, если пользователь явно спрашивает: «Какое правило действовало в марте?»
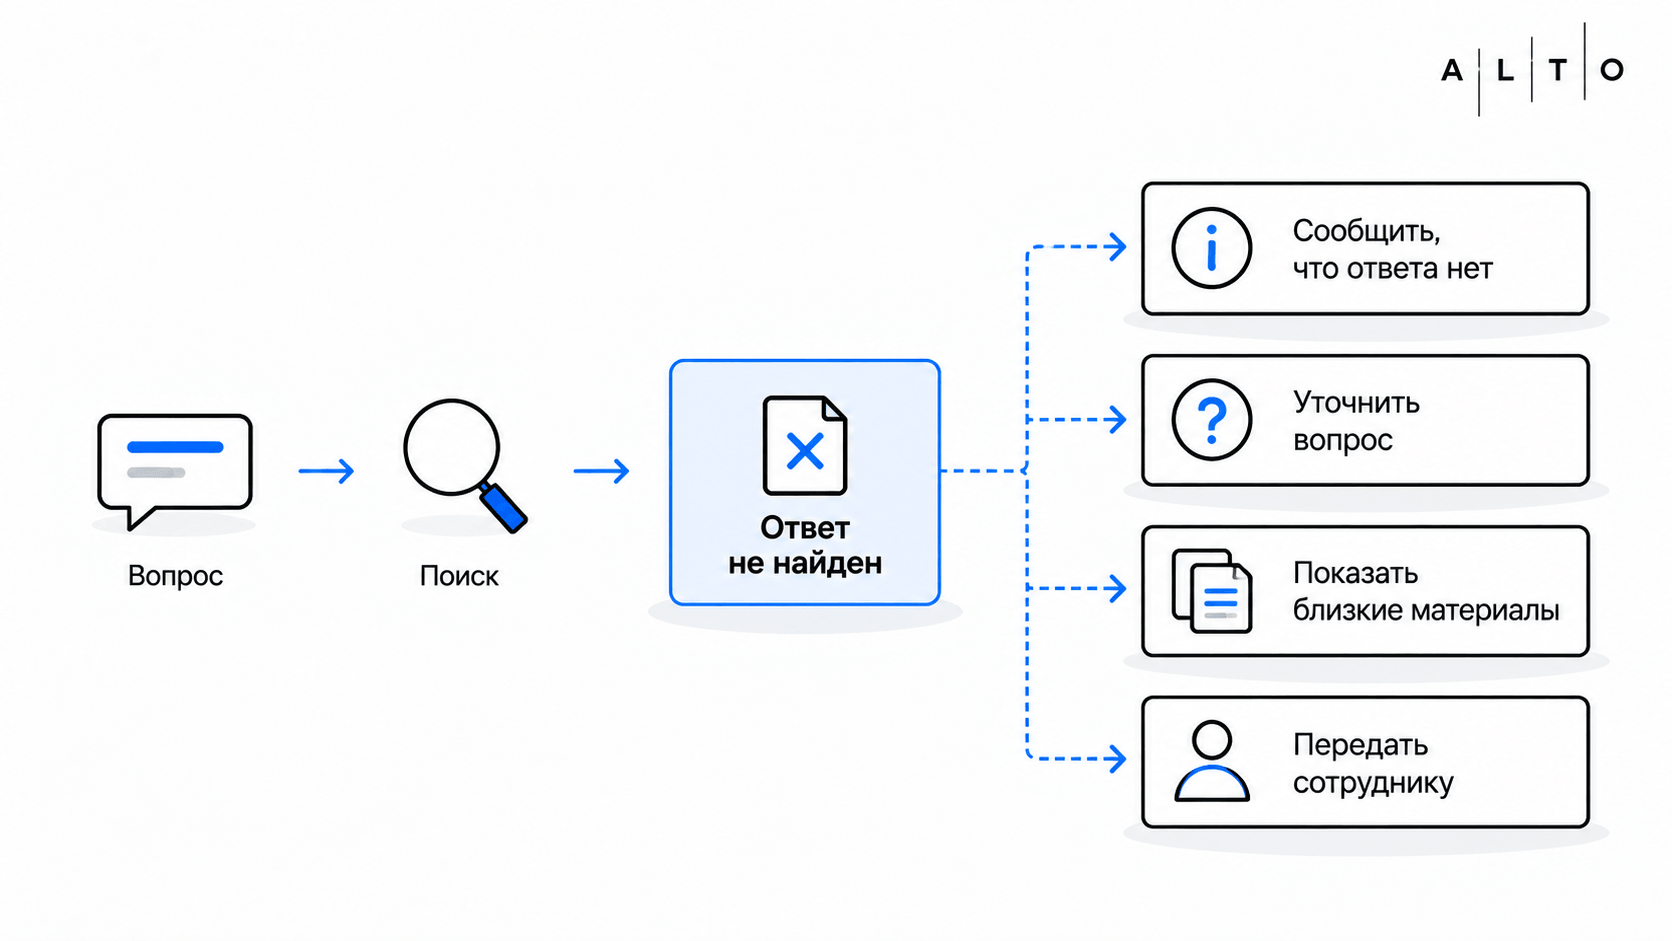
Что происходит, если ответа в документах нет
Хорошая RAG-система не должна воспринимать отсутствие информации как приглашение что-нибудь придумать.
Можно заранее определить несколько сценариев:
- сообщить, что в доступных документах ответа нет;
- попросить пользователя уточнить вопрос;
- показать наиболее близкие материалы без утверждения, что они содержат ответ;
- передать запрос сотруднику.
Использовать общие знания языковой модели тоже возможно, но это должно быть осознанным правилом системы. Например, внутренний ИИ-консультант может быть настроен строго: отвечать только по корпоративной базе. А публичный помощник — использовать общие знания для нейтральных вопросов, но корпоративные факты брать исключительно из утвержденных источников.
Почему RAG снижает риск вымышленных ответов, но не исключает ошибки
RAG дает модели релевантный внешний контекст вместо необходимости опираться только на собственные параметры. Это снижает вероятность того, что система будет придумывать неизвестные ей корпоративные факты.
Но ошибки остаются возможны:
- система может найти не тот документ;
- выбрать фрагмент, в котором отсутствует важное исключение;
- источник может оказаться устаревшим;
- языковая модель может неверно сопоставить несколько найденных условий.
Поэтому корректнее говорить, что RAG снижает риск вымышленных ответов, а не «устраняет галлюцинации» или «гарантирует точность».
Как учитывать права доступа
Поиск по корпоративной базе знаний должен учитывать не только релевантность, но и права пользователя.
Пользователь → его полномочия → доступные документы → поиск → ответ
Например, сотрудник отдела продаж может иметь доступ к продуктовым инструкциям и коммерческим условиям, но не к внутренним кадровым документам. Даже если закрытый документ идеально соответствует его вопросу по смыслу, он не должен попасть в найденный контекст. Ограничение только на уровне интерфейса недостаточно. Если модель уже получила закрытый фрагмент, чувствительная информация фактически попала в обработку ответа. Поэтому контроль доступа должен применяться еще на этапе извлечения информации.
Как проверяют качество поиска и ответа
При оценке RAG полезно разделять две разные задачи.
Первая — качество поиска:
- нашла ли система правильный документ;
- выбрала ли правильный фрагмент;
- не пропустила ли важную информацию;
- не предпочла ли устаревшую версию.
Вторая — качество генерации:
- соответствует ли ответ полученному контексту;
- не добавила ли модель неподтвержденные сведения;
- правильно ли объединила информацию из нескольких источников;
- корректно ли указала ссылки.
Это разделение важно при разборе ошибок. Если система ответила неправильно потому, что поиск вернул не тот договор, замена языковой модели может ничего не исправить. И наоборот: если поиск нашел правильный пункт, но модель неверно его истолковала, проблема находится уже на этапе генерации.
Чем RAG отличается от других подходов и когда его использовать
RAG — не универсальный способ работы с корпоративными документами. Для некоторых задач проще использовать обычный поиск или напрямую передать документ языковой модели.
| Подход | Что делает | Когда подходит | Как обновляются знания | Формирует готовый ответ | Можно показать источник |
|---|---|---|---|---|---|
| Обычный поиск | Находит документы или страницы | Нужно найти исходный материал | Через обновление поискового индекса | Обычно нет | Да |
| Документы в контексте LLM | Модель сразу получает выбранные файлы | Документов немного, задача разовая | Пользователь передает актуальные файлы | Да | Зависит от реализации |
| Дообучение модели | Изменяет параметры модели | Нужно устойчиво изменить поведение, формат или специализированный навык | Требуется новый цикл подготовки и обучения | Да | Не является механизмом цитирования источников |
| RAG | Ищет нужные внешние сведения и передает их модели | База большая, изменяется и нужен готовый ответ | Обновляются документы и индекс | Да | Да, если сохранена связь с источником |
Можно ориентироваться на такой сценарий:
- если нужен сам документ — достаточно поиска;
- если файлов немного и задача разовая — их можно передать модели напрямую;
- если знания регулярно меняются, документов много и на каждый вопрос нужно находить только релевантную часть — стоит рассматривать RAG.
RAG и обычный поиск
Обычный поиск отвечает на вопрос: «Где находится нужная информация?» Он возвращает список файлов, страниц или фрагментов. RAG может сделать следующий шаг: «Что в найденных материалах отвечает на вопрос пользователя?» Система передает найденные сведения модели, а та собирает из них готовый ответ.
Обычный поиск при этом может быть лучшим решением, если пользователь должен самостоятельно изучить первоисточник и генерация ответа не дает дополнительной ценности.
RAG и дообучение модели
Дообучение и RAG решают разные задачи. RAG дает модели доступ к внешним знаниям во время запроса. Если компания поменяла инструкцию, можно обновить документ и поисковый индекс. Дообучение изменяет параметры самой модели. Его чаще используют, когда нужно устойчиво изменить поведение, формат, стиль ответа или специализированный навык. Это не означает, что подходы взаимоисключающие. Дообученная модель также может использовать RAG. Но переобучать модель только ради каждого изменения корпоративного регламента обычно не требуется.
RAG и длинный контекст
Современной языковой модели можно передавать довольно большие документы непосредственно в запросе. Если аналитик работает с тремя договорами и хочет один раз их сопоставить, отдельная RAG-система может быть избыточна. RAG становится полезнее, когда документов сотни или тысячи, база регулярно обновляется и при каждом запросе нужно автоматически выбрать лишь небольшую релевантную часть. Здесь важен не только допустимый размер контекста модели, но и сама задача поиска, управления версиями, правами и источниками.
Как связаны RAG, ИИ-ассистент и ИИ-агент
RAG — способ получить внешние знания для модели. ИИ-ассистент — прикладное решение, которое может использовать RAG, чтобы отвечать по корпоративным документам. Такое решение иногда называют RAG-ассистентом: пользователь работает с обычным диалоговым интерфейсом, а поиск по базе знаний происходит внутри системы. ИИ-агент тоже может обращаться к RAG как к одному из своих инструментов. Например, сначала найти в базе знаний правила выполнения операции, а затем на их основе выбрать следующее действие. Но наличие RAG само по себе не делает систему ИИ-агентом.
Где RAG применяют в бизнесе
RAG особенно полезен там, где сотрудники или клиенты регулярно задают вопросы по большой и изменяемой базе документов.
Корпоративная база знаний для сотрудников
Корпоративный RAG связывает языковую модель с внутренними источниками компании и позволяет отвечать по актуальным регламентам, инструкциям и другим материалам. В компании могут храниться сотни регламентов, инструкций и внутренних правил, а сотруднику не всегда понятно, где именно искать нужную информацию. База знаний с ИИ может позволить задать вопрос естественным языком:
- «Как оформить командировку?»
- «Кто согласует закупку выше определенной суммы?»
- «Как действовать при возврате товара клиентом?»
RAG находит подходящие корпоративные материалы, а языковая модель формирует ответ и показывает источник. Это особенно полезно для новых сотрудников и процессов, где информация распределена между несколькими документами.
Поддержка клиентов и ИИ-консультанты
RAG может быть основой ИИ-консультанта, который отвечает по актуальной продуктовой документации, тарифам, инструкциям, правилам обслуживания и другим утвержденным материалам. Например, клиент спрашивает, поддерживает ли конкретная модель оборудования определенный режим. Вместо ответа из общих знаний модель получает техническую документацию именно по этой модели. Если информации нет, система может передать вопрос оператору, а не додумывать характеристику.
Продажи и работа с продуктовой информацией
В B2B-продажах информация может одновременно находиться в каталогах, прайс-листах, карточках товаров, коммерческих правилах и внутренней документации. RAG помогает искать конкретные характеристики, условия поставки, ограничения и другую информацию, которую сотруднику пришлось бы собирать вручную из нескольких источников.
При этом если задача требует не только найти сведения, но и самостоятельно выполнить последовательность действий в CRM, ERP или других системах, одного RAG уже недостаточно. Это другой уровень автоматизации.
Работа с договорами и другими документами
RAG можно использовать для поиска конкретных фактов, условий и пунктов в договорах, технической документации и других корпоративных материалах. Например: «Какой срок уведомления о расторжении предусмотрен договором?» Система ищет подходящий пункт и показывает его вместе с источником. Но готовый ответ ИИ не должен автоматически восприниматься как юридическое заключение. Для важных решений пользователь должен иметь возможность открыть исходный документ и проверить контекст.
Когда RAG может быть избыточным
Сам факт наличия документов еще не означает, что компании нужна RAG-система. Если есть один небольшой регламент, который редко меняется, может хватить обычного поиска. Если сотрудник разово анализирует несколько известных файлов, проще передать их языковой модели непосредственно. Если задача состоит в точном поиске номера заказа в структурированной базе данных, генеративный слой может вообще не понадобиться.
RAG начинает иметь смысл, когда документов много, они меняются и пользователю нужен готовый ответ с источником:
- информации много;
- она распределена между разными источниками;
- документы обновляются;
- пользователю нужен не только список файлов, но и готовый ответ;
- нужно указывать источник;
- поиск по формулировке вопроса сложнее простого совпадения слов;
- есть понятные правила актуальности и доступа.
Если нужно определить, где в процессе нужен RAG, а где достаточно поиска, интеграции или обычной LLM, это уже часть проектирования и внедрения ИИ-решения.
Главное о RAG
В базовом RAG-подходе документы компании не используются для переобучения языковой модели. Перед формированием ответа система находит подходящую информацию во внешней базе знаний и передает модели релевантные фрагменты как дополнительный контекст. Поэтому при изменении регламента, инструкции или другого источника можно обновить документы и поисковый индекс, а не переобучать модель.
Векторный поиск — распространенный, но не обязательный компонент RAG. Он помогает находить информацию по смыслу, тогда как для артикулов, номеров договоров, кодов и других точных значений может быть полезнее поиск по словам. В корпоративных системах эти способы часто сочетают.
Чтобы пользователь мог проверить ответ по первоисточнику, при подготовке базы знаний нужно сохранять связь каждого фрагмента с исходным документом и его метаданными: названием, разделом, страницей, датой, версией и другими необходимыми сведениями.
Качество RAG зависит не только от языковой модели. Важны актуальность и качество документов, работа поиска, учет версий и прав доступа, а также правила поведения системы, если нужной информации в базе нет. RAG снижает риск вымышленных ответов за счет внешнего контекста, но не исключает ошибок и не гарантирует точность.